Um 02:00 Uhr nachts, wenn ein korrumpierter Pointer in einer benutzerdefinierten BSFNBusiness Function: Ausführbare C- oder Event-Rule-Logikkomponente zur Geschäftsverarbeitung in JD Edwards. zur Bestandsallokation die Kommissionierbestätigung in drei Distributionszentren lahmlegt, reagieren viele Teams mit Panik. Technische Leiter stehen unter erheblichem Druck, die Object Management WorkbenchZentrales JDE-Entwicklungswerkzeug (OMW) zur Verwaltung, Versionierung und Verteilung von Objekten. zu umgehen, Event RulesProprietäre Programmiersprache in JD Edwards zur Definition von Geschäftslogik in Formularen und Tabellen. direkt in PDProduction: Die Produktivumgebung in JD Edwards EnterpriseOne. anzupassen oder eine manuell kompilierte .dll unmittelbar auf den Enterprise ServerZentraler JDE-Server für Batch-Jobs (UBEs) und die Ausführung kompilierter C-Business-Functions. zu kopieren. Das wirkt wie eine Zehn-Minuten-Rettung. In Wahrheit vergiften solche spekulativen Overrides die Central ObjectsZentrale Datenbanktabellen, die den autoritativen Quellcode und Spezifikationen aller JDE-Objekte enthalten., erzeugen verwaiste Spezifikationen und garantieren nahezu, dass das nächste reguläre Full Package DeploymentVollständiges Software-Paket, das alle EnterpriseOne-Objekte einer Umgebung neu baut und verteilt. die Produktion erneut lahmlegt.
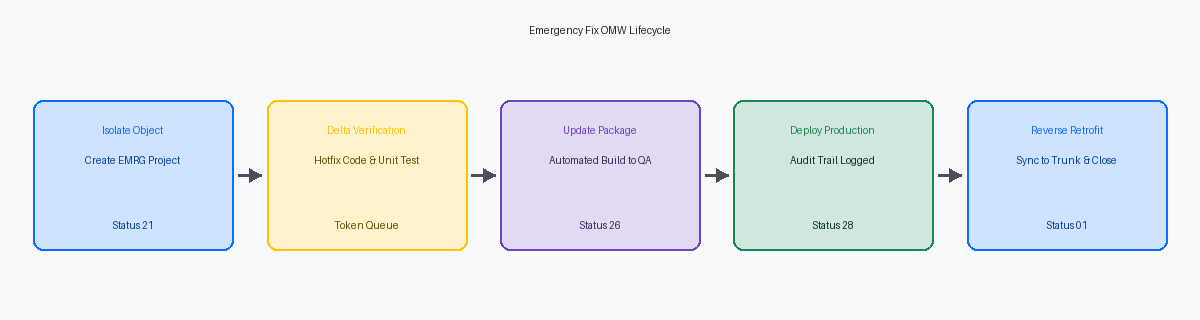
Notfalleindämmung erfordert keine technische Anarchie. Die disziplinierte Umsetzung eines JDE OMW Emergency-Fix-Workflows ohne Kontrollverlust ermöglicht es einem CNCConfigurable Network Computing: Die Systemarchitektur und Rolle der Administratoren in JD Edwards.- und Entwickler-Gespann, das betroffene Objekt zu isolieren, ein gezieltes Update PackageInkrementelles Software-Paket in JDE, das gezielt nur veränderte Objekte enthält und verteilt. zu bauen und den verifizierten Fix typischerweise innerhalb von 60 bis 90 Minuten bereitzustellen. Dieses Protokoll schützt aktive EntwicklungstokensExklusiver Sperrmechanismus in OMW, der gleichzeitige Modifikationen desselben Objekts verhindert. laufender Sprint-Teams in DV920Development: Der Standard-Pfadcode bzw. die Entwicklungsumgebung in Version 9.2 von JDE., wahrt einen auditierbaren elektronischen Prüfpfad für Compliance-Vorgaben und stellt sicher, dass der Hotfix nachfolgende Package Builds unversehrt übersteht.
Das architektonische Risiko von Produktions-Hotfixes
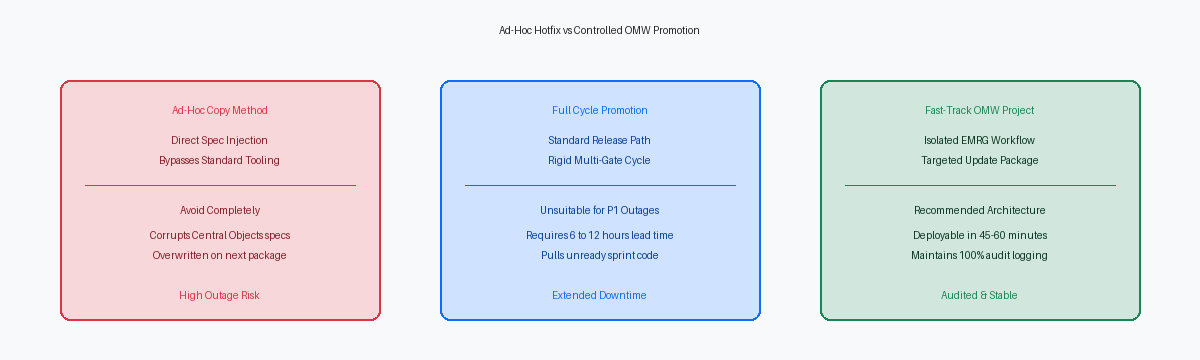
Unter Sev-1-Druck ist die schnellste Abkürzung oft die verheerendste: die direkte Modifikation von Central Objects per SQL oder das manuelle Einspielen von Spec-Datensätzen. Das Umgehen der Object Management Workbench beschädigt unmittelbar die Datensätze im Object Master (F9860) und Object Librarian Status (F9861). Sobald eine Zeile in F9861 nicht mehr synchron mit den relationalen Tabellen der Central Objects läuft, geht die PathcodeVerzeichnis- und Datenbanksatz in JDE, der den Codebestand einer spezifischen Umgebung darstellt.-Parität verloren. EnterpriseOne verliert die referenzielle Integrität, die festlegt, welches Environment die freigegebene Version der Komponente besitzt.
Die unmittelbaren Folgen treffen primär die Enterprise Server. Wird BSFN-Logik ohne koordinierte Bereitstellung der Spezifikationen geändert, entsteht eine Diskrepanz zwischen den kompilierten Laufzeit-DLLs (oder Shared Objects unter Linux) und den serialisierten Spezifikationen im Cache der Kernel-Prozesse. Dieser Versatz führt zu Speicherfehlern, bringt den Call Object KernelHintergrundprozess auf dem Enterprise Server zur Ausführung von Business-Function-Aufrufen. zum Absturz und erzeugt kaskadierende Zombie-Prozesse, die interaktive Benutzersitzungen trennen. Eine unkontrollierte C-Modifikation zur Behebung von Problemen in der Auftragsbearbeitung kann schnell eine gesamte Enterprise-Server-Instanz lahmlegen.
Selbst wenn der Server stabil bleibt, garantieren Out-of-Band-Modifikationen ein verzögertes Desaster. Der nächste geplante Full Package Build kompiliert saubere Spezifikationen strikt aus dem Central-Objects-Repository, das in der Deployment-Umgebung gemappt ist. Jede manuell auf dem Enterprise Server ausgetauschte Binärdatei oder außerhalb von OMW geänderte Tabellendefinition wird stillschweigend überschrieben. Der Hotfix verschwindet ohne Audit-Trail, wodurch der Produktionsfehler während des nächsten planmäßigen Wartungsfensters wieder auftritt.
Betrieblicher Druck entbindet ein Unternehmen nicht von den Gesetzmäßigkeiten der Systemarchitektur. Ein kontrollierter Notfallpfad erfordert eine konsequente Single-Path-Repository-Disziplin, bei der jedes Byte auf dem Weg in die Produktion reguläre Token-Validierungen, protokollierte Statuswechsel und auditierbare Update Packages durchläuft.
Konfiguration eines isolierten, kontrollierten Projekt-Branches
Kommt es zu einem Ausfall mit Severity 1 in der Produktion, checken Entwickler das fehlerhafte Objekt häufig reflexartig in das aktive Entwicklungsprojekt ein, das sie gerade geöffnet haben. Dieses Verhalten führt regelmäßig dazu, dass Hotfixes mit unveröffentlichtem Sprint-Code kontaminiert werden. Erzwingen Sie eine saubere Trennung durch einen isolierten Projekt-Container mit einer strikten Namenskonvention wie EMRG_[Issue#]. Diese Trennung stellt sicher, dass der Notfall-Payload vollständig von regulären Release-Zyklen entkoppelt bleibt, wodurch verhindert wird, dass ungeprüfte funktionale Änderungen in die Produktion gelangen.
Die Scope-Disziplin innerhalb dieses Containers muss absolut sein. Das Projekt darf ausschließlich die ein oder zwei Artefakte enthalten, die direkt für die Fehlerbehebung erforderlich sind – meist eine isolierte C-Business-Function, ein Tabellen-Trigger oder eine Batch-Applikation. Müssen aufrufende Datenstrukturen oder zugehörige Formulare überprüft werden, müssen diese Definitionen im Pathcode unverändert bleiben. Werden periphere Abhängigkeiten in das aktive Projekt gezogen, steigt das Risiko unbeabsichtigter Check-ins, wodurch ein gezielter Single-Object-Patch zu einem unkontrollierten Deployment anwächst.
Um die erforderliche Geschwindigkeit zu gewährleisten, werden dedizierte OMW Activity RulesRegelwerk in JD Edwards, das steuert, welche Aktionen und Statusübergänge für Objekte zulässig sind. benötigt, die speziell für Notfallszenarien definiert sind und mehrwöchige Entwicklungsphasen umgehen. Statt das Projekt durch die vollständige Sequenz von Status 21 bis Status 26 zu leiten, etablieren Sie einen expliziten Übergangspfad: von Status 21 direkt in eine beschleunigte Testphase bei Status 25 und anschließend direkt zu Status 28 für den Transfer in Central Objects - PD. Innerhalb dieses Pfads müssen verbindliche Projektrollen durchgesetzt werden. Der Entwickler, der den Code anpasst, darf weder die Freigabe- noch die Deployment-Rolle innehaben; die Funktionstrennung (Segregation of Duties) zwischen Entwickler und CNC muss auch während eines nächtlichen Incident-Calls bestehen bleiben.
Token-Management bei gleichzeitigem Schutz laufender Arbeiten
Produktionsausfälle richten sich selten nach Sprint-Zyklen. Wenn eine kritische Auftragserfassungs-BSFN zum Monatsende ausfällt, ist dieses Objekt in DV920 fast immer im Rahmen einer laufenden Funktionserweiterung ausgecheckt. Die abrupte Freigabe dieses Tokens zur Beschleunigung des Notfalls macht unkompilierte Codeänderungen im Entwicklungs-Pathcode ungültig. EnterpriseOne verwaltet die Checkout-Zuständigkeit und die Warteschlangenreihenfolge in der Tabelle F98611; das manuelle Übersteuern dieser Sperren beschädigt Spezifikationen in Arbeit und unterbricht die Entwicklersynchronisation.
Stabile Notfall-Workflows stützen sich auf die native Token-Warteschlange in F98611. Das Notfallteam reiht sein Projekt in die Warteschlange ein oder initiiert eine Vererbungsprüfung, sodass Entwickler einen Checkout durchführen können, ohne das primäre Token zu halten. Dies ermöglicht eine gezielte Fehleranalyse auf Basis des produktionsgleichen Spezifikationsstands, ohne die Verbindung zwischen dem aktiven Feature-Branch und dem gemeinsamen zentralen Repository zu trennen.
Erfordert die Fehlerbehebung eine zwingende Token-Übertragung, muss der zuständige CNC mit definierten Sicherheitsmaßnahmen eingreifen. Bevor das Token an das Notfallprojekt freigegeben wird, muss der aktive Entwickler einen expliziten Delta-Export seines aktuellen Arbeitsstands in ein lokales .par-SpezifikationsarchivJD Edwards Portable Archive (.par): Komprimierte Archivdatei zum Sichern und Transportieren einzelner Objekte. durchführen. Wird dieser Schritt übersprungen, gehen nicht committete Event Rules oder modifizierte Datenstrukturen, die nur in der lokalen Spezifikationsdatenbank liegen, bei der Aktualisierung der Central Objects verloren.
Sobald das Notfall-Update-Package in PD920Die Produktionsumgebung in Version 9.2 von JD Edwards EnterpriseOne. bereitgestellt und die Projektpromotion abgeschlossen ist, geben automatisierte Wiederherstellungsprotokolle das primäre Token an die ursprüngliche Projekt-Warteschlange zurück. Der Feature-Entwickler importiert das .par-Archiv zurück nach DV920, führt das eingespielte Produktions-Delta zusammen und setzt die Entwicklung ohne Datenverlust fort.
Update Package Builds und Sicherung des Audit-Trails
Bei einem Produktionsausfall ist die Versuchung groß, die Paketerstellung zu umgehen und Spezifikationen direkt zwischen Pathcodes zu kopieren. Genau hier beginnen Speicherbeschädigungen. Notfall-Promotionen müssen zwingend über gezielte Update Packages und nicht über Ad-hoc-Spec-Transfers erfolgen, um sicherzustellen, dass kompilierte C-Business-Functions konsistente Shared Libraries erzeugen. Direkte Spezifikationskopien führen dazu, dass der Enterprise Server im Arbeitsspeicher veraltete Binärdateien gegen neu aktualisierte Spezifikationen ausführt.
Die Erstellung eines Update Packages, das ausschließlich die betroffenen Objekte enthält, dauert auf moderner Infrastruktur typischerweise 15 bis 30 Minuten. Dieser Kompilierungszyklus baut den C-Quellcode zuverlässig, packt die Spezifikationsdatensätze und aktualisiert die Deployment-Historientabellen in der Planner-Datenbank. Das Überspringen dieses Schritts erzeugt einen inkonsistenten Build-Zustand auf dem Enterprise Server, was nahezu garantiert, dass das nächste reguläre Full Package fehlschlägt oder die Notfalländerung unerwartet überschreibt.
Die Einhaltung dieser Paketierungsdisziplin sichert regulatorische Kontrollen auch unter hohem betrieblichem Druck. Jeder über OMW ausgeführte Promotionsvorgang schreibt automatisch einen unveränderlichen Protokolldatensatz in die Tabellen F9863 und F9864, inklusive Benutzer-IDs, Zeitstempeln, Quell-Pathcodes und Zielumgebungen. Prüfen externe SOX- und IT-Auditoren außerplanmäßige Produktions-Releases, belegen diese systemgenerierten Einträge die Einhaltung der Funktionstrennung, ohne dass nachträglich erstellte Change-Tickets erforderlich sind.
Nach dem Deployment des Pakets muss der Release-Prozess auf der Runtime-Ebene sauber abgeschlossen werden. Über den Server ManagerWebbasierte Verwaltungskonsole von Oracle zur Überwachung, Konfiguration und Steuerung von JDE-Serverinstanzen. sollten gezielte Kernel-Recycles oder Soft Bounces statt unkoordinierter Server-Neustarts ausgeführt werden, um Benutzersitzungen in nicht betroffenen Umgebungen zu schützen. Durch das gezielte Zurücksetzen der relevanten Call Object Kernel werden die neuen Business-Function-Libraries sofort geladen, wodurch das Problem behoben wird, ohne aktive Lagerscanner oder interaktive Sitzungen in der Fertigung zu unterbrechen.
Entwicklung eines ausführbaren Rollback-Mechanismus
Natives JDE OMW bietet keine Ein-Klick-Rollback-Funktion. Sobald ein Update Package in PD920 bereitgestellt ist, überschreiben Central Objects und Laufzeitspezifikationen den Produktions-Pathcode irreversibel – es sei denn, vor der Durchführung wurde ein Ausstiegspfad vorbereitet. Sich darauf zu verlassen, dass ein Entwickler eine unvollständige BSFN nach einem fehlgeschlagenen nächtlichen Notfall-Fix manuell rekonstruiert oder eine APPL-Definition neu erstellt, verwandelt kurze Vorfälle schnell in mehrstündige Ausfälle. Ein ausführbarer Rollback-Mechanismus muss vollständig bereitstehen, bevor das Deployment beginnt.
Bevor das Notfallprojekt aus dem Test-Pathcode hochgestuft wird, muss das CNC-Team den fehlerfreien Ausgangszustand sichern. Exportieren Sie den aktuellen Zustand des Objekts direkt aus PD920 in eine Rollback-par-DateiProprietäres Archivformat (Portable Archive) zum Sichern einzelner JDE-Objektspezifikationen. oder erstellen Sie vorab ein Snapshot-Paket über das reguläre Package Management. Hinterlegen Sie diesen intakten Code in einem gespiegelten Rollback-Projekt mit einem inaktiven OMW-Status, wie Status 26. Schlagen die Smoke-Tests innerhalb der ersten 15 Minuten nach dem Deployment fehl, kann das Projekt direkt auf Status 38 gesetzt werden, um den vorherigen stabilen Zustand ohne Verzögerungen durch Checkout-Konflikte wiederherzustellen.
Das Bereitstellen von Ersatz-Spec-Paketen auf Enterprise Servern löst nur einen Teil des Problems. Moderne HTML-Engines cachen Metadaten intensiv und schreiben in die Tabellen F989999 und F989998 für serialisierte Spezifikationen. Jeder Notfallplan, der die Synchronisation der Laufzeitspezifikationen auslässt, führt dazu, dass Endanwender auf der Java-Ebene auf beschädigte Formulare oder veraltete Logik treffen. Das Rollback-Playbook muss daher einen expliziten Cache-Flush über den Server Manager auf allen Produktions-Webservern oder einen rollierenden Neustart vorschreiben, damit die JAS-InstanzenJava Application Server: Webserver-Komponente in JD Edwards, die HTML-Oberflächen für Benutzer generiert. alte Spezifikationsdatensätze verwerfen und auf Basis des wiederhergestellten Stands neu serialisieren.
Post-Deployment-Retrofitting und Projektabschluss
Die meisten regressionsbedingten Produktionsprobleme im Zusammenhang mit Notfall-Fixes treten nicht während des Vorfalls auf, sondern Wochen später bei einem regulären Wartungs-Release. Endet der Workflow in Ihrem Team unmittelbar nach dem Deployment des Update Packages in PD920, verbleibt ein ungepatchtes Code-Delta in DV920 und PY920Prototype/Testumgebung in JD Edwards Release 9.2 für Qualitätssicherung und User-Acceptance-Tests.. Sobald das nächste geplante Projekt die Pipeline durchläuft, überschreiben diese älteren, nicht nachgezogenen Spezifikationen den Hotfix in der Produktion und reaktivieren den zuvor behobenen Fehler.
Ein Notfall-Fix ist technisch erst abgeschlossen, wenn der Rückwärts-Merge über alle Pathcodes hinweg durchgeführt wurde. Öffnen Sie das aktive Feature-Projekt, das aktuell das primäre Token hält, und starten Sie das Tool Visual CompareGrafisches JDE-Vergleichswerkzeug zur visuellen Analyse von Spezifikationsunterschieden zwischen Objekten. gegen die Spezifikationen des Notfallprojekts für alle geänderten APPL-, UBEUniversal Batch Engine: Reporting- und Batch-Verarbeitungsprozessor in JD Edwards.- oder NERNamed Event Rule: Über Event Rules modellierte Business Function, die in C-Code übersetzt wird.-Objekte. Bei benutzerdefinierten C-BSFNs führen Sie einen Split-Screen-Diff der .c- und .h-Quelldateien direkt im DV920-Entwicklungsverzeichnis durch. Das Zusammenführen der Notfalllogik in den aktiven Feature-Branch stellt sicher, dass der nächste Baseline-Build den Hotfix übernimmt, anstatt ihn zu überschreiben.
Der letzte operative Schritt ist der formale Abschluss des Containers. Setzen Sie das OMW-Notfallprojekt auf Status 01 (Complete). Dieser Statuswechsel aktiviert drei verbindliche Kontrollmechanismen: Er gibt sekundäre oder wartende Tokens dauerhaft frei, entzieht Checkout-Berechtigungen und sperrt die OMW-Aktivitätsprotokolle in F98210 und F98211 gegen nachträgliche Änderungen. Bis das Projekt Status 01 erreicht, bleibt der Audit-Trail für Compliance-Prüfungen angreifbar und die Pathcodes bleiben potenziell asynchron.
Um diese Promotion-Pipeline abzusichern, müssen dringende Fehlerbehebungen als standardisierte, wiederholbare Pfade innerhalb des zentralen Change-Management-Frameworks behandelt werden – nicht als Ad-hoc-Ausnahmen. Überprüfen Sie Ihre OMW Activity Rules und automatisierten Package-Deployment-Skripte, bevor der nächste Sev-1-Vorfall unvorbereitete Entscheidungen erzwingt.