À 02h00, lorsqu'un pointeur corrompu dans une BSFNBusiness Function : module de code exécutable écrit en C ou en Event Rules dans JD Edwards. personnalisée d'allocation des stocks bloque la confirmation de prélèvement sur trois centres de distribution, la réaction habituelle est la panique. Les responsables techniques subissent une pression immense pour contourner l'Object Management WorkbenchOutil centralisé de JD Edwards pour la gestion des cycles de vie et des promotions d'objets., modifier les Event RulesLangage de script interne à JD Edwards pour programmer la logique métier. directement en PD ou déposer un fichier .dll compilé manuellement directement sur un Enterprise ServerServeur d'applications central exécutant la logique métier et les traitements par lots.. Cela donne l'impression d'un sauvetage en dix minutes. En réalité, ces surcharges spéculatives empoisonnent les Central ObjectsRéférentiel de base de données stockant l'ensemble du code et des spécifications JD Edwards., injectent des spécifications parasites qui subsistent en silence et garantissent que votre prochain déploiement de package full programmé fera à nouveau exploser la production.
La gestion d'une crise n'exige pas l'anarchie technique. L'exécution d'un workflow de correctif d'urgence JDE OMW discipliné et maîtrisé permet à un binôme CNCConfigurable Network Computing : architecture et rôle d'administrateur système technique JD Edwards. et développeur d'isoler l'objet impacté, de construire un package de mise à jour ciblé et de déployer un correctif vérifié, généralement en 60 à 90 minutes. Ce protocole protège les jetons de développement actif détenus par les équipes en plein sprint dans DV920Environnement standard de développement dans JD Edwards EnterpriseOne 9.2., conserve une piste d'audit électronique pour la conformité et garantit que le hotfix survit intact aux générations de packages ultérieures.
Le risque architectural des hotfixes en production
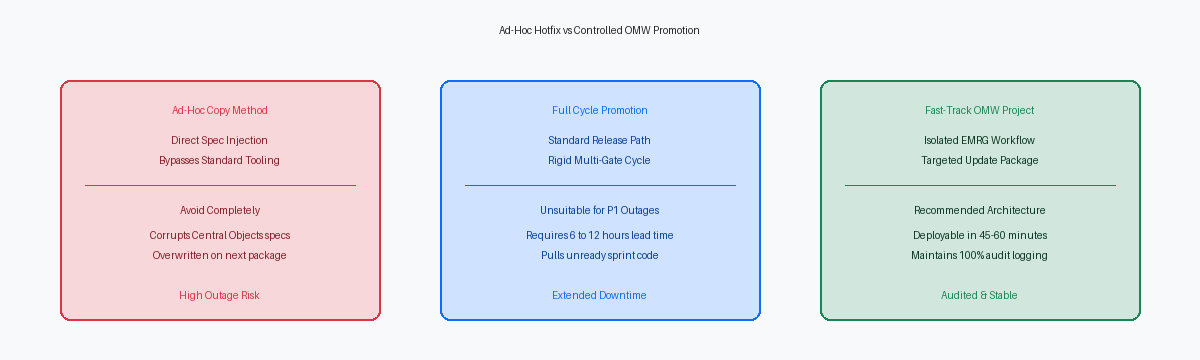
Sous la pression d'un incident Sev-1, le raccourci le plus rapide est souvent le plus catastrophique : mettre à jour les Central Objects directement via SQL ou injecter manuellement des enregistrements de spécifications. Contourner l'Object Management Workbench corrompt immédiatement les enregistrements du master d'objet (F9860) et du statut de l'Object Librarian (F9861). Dès qu'une ligne de la F9861 perd sa synchronisation avec les tables relationnelles des Central Objects, la parité des pathcodesEmplacements spécifiques définissant l'ensemble des règles et spécifications d'un environnement JD Edwards. s'effondre. EnterpriseOne perd l'intégrité référentielle qui définit quel environnement détient la version approuvée de ce composant.
Le mode de défaillance immédiat frappe directement vos Enterprise Servers. Modifier la logique d'une BSFN sans une livraison coordonnée des spécifications crée un décalage entre les DLL d'exécution compilées (ou objets partagés sous Linux) et les spécifications sérialisées mises en cache par les processus kernel. Ce décalage structurel déclenche un désalignement de mémoire, faisant planter le Call Object Kernel et générant des processus zombies en cascade qui interrompent les sessions interactives des utilisateurs. Une modification C non maîtrisée pour corriger le traitement des commandes neutralisera rapidement une instance complète d'Enterprise Server.
Même si le serveur reste stable, les modifications hors bande garantissent une catastrophe différée. La prochaine génération de package full planifiée compile des spécifications propres strictement à partir du référentiel Central Objects mappé dans votre environnement de déploiement. Tout binaire échangé manuellement sur un Enterprise Server ou toute définition de table modifiée hors d'OMW est écrasé sans avertissement. Le hotfix disparaît sans laisser de trace d'audit, ressuscitant l'anomalie de production lors d'une fenêtre de maintenance de routine.
La pression opérationnelle ne peut dispenser une organisation des lois physiques du système. Un chemin d'urgence contrôlé exige une discipline absolue de référentiel à voie unique, où chaque octet acheminé vers la production passe par la validation standard des jetons, l'avancement consigné des statuts et des packages de mise à jour auditables.
Configuration d'une branche de projet contrôlée et isolée
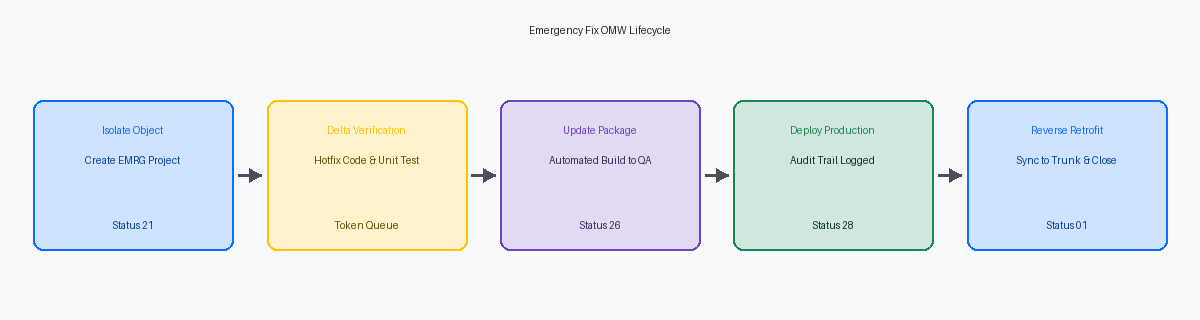
Lorsqu'un arrêt de production critique survient, le réflexe des développeurs est d'extraire l'objet défaillant dans le projet de développement actif déjà ouvert sur leur poste. Cette simple habitude contamine couramment les hotfixes avec du code de sprint non finalisé. Imposez une rupture nette en créant un conteneur de projet isolé doté d'une convention de nommage stricte, telle que EMRG_[Issue#]. Cette ségrégation garantit que le contenu urgent reste entièrement détaché des cycles de release planifiés, éliminant ainsi le risque de glissement de modifications fonctionnelles non validées vers la production.
La rigueur sur le périmètre au sein de ce conteneur doit être totale. Le projet doit contenir exclusivement le ou les deux artefacts directement responsables du correctif, généralement une fonction C isolée, un déclencheur de table ou un traitement batch. Si un ingénieur a besoin d'inspecter les structures de données appelantes ou les écrans d'application associés, ces définitions doivent rester intactes dans le pathcode. Ajouter des dépendances périphériques dans le projet actif incite à des archivages accidentels, transformant un patch ciblé sur un seul objet en un déploiement non maîtrisé.
La gestion des délais nécessite des OMW activity rules adaptées et configurées spécifiquement pour les scénarios d'urgence, contournant les étapes de développement standard réparties sur plusieurs semaines. Plutôt que de forcer le projet à suivre toute la progression du Statut 21 au Statut 26, mettez en place un chemin de transition explicite passant directement du Statut 21 à une phase de test accélérée au Statut 25, puis directement au Statut 28 pour le transfert vers Central Objects - PD. Le responsable de projet doit appliquer des rôles de projet obligatoires au sein de ce chemin. Le développeur qui corrige le code ne peut pas détenir le rôle d'approbation ou de déploiement ; la séparation des tâches appliquée par le système entre le programmeur et le CNC doit subsister, même lors d'une cellule de crise en pleine nuit.
Gestion des jetons et préservation du travail en cours
Les arrêts de production attendent rarement la fin d'un sprint. Lorsqu'une BSFN critique de saisie de commandes plante en clôture mensuelle, cet objet est presque systématiquement extrait dans DV920 au titre d'une évolution fonctionnelle en cours. Libérer brutalement ce jeton pour libérer le passage invalide les modifications de code en cours, non compilées dans le pathcode de développement. EnterpriseOne suit la propriété de l'extraction et la séquence de la file d'attente dans la table F98611 ; forcer manuellement ces verrous corrompt les spécifications du travail en cours et brise la synchronisation des développeurs.
Les workflows d'urgence fiables reposent sur la file d'attente native des jetons gérée dans la F98611. L'équipe du correctif urgent place son projet dans la file d'attente ou déclenche une vérification d'héritage, ce qui permet aux développeurs d'exécuter un checkout sans détenir le jeton principal. Cela autorise un diagnostic ciblé sur des spécifications identiques à la production sans rompre le lien entre la branche fonctionnelle active et le référentiel central partagé.
Lorsque l'intervention sur le code exige un transfert absolu du jeton, le responsable CNC doit intervenir avec des garde-fous rigoureux. Avant de céder le jeton au projet d'urgence, le développeur actif doit effectuer une exportation explicite de son delta de travail en cours dans une archive locale de spécifications .par. L'omission de cette étape entraîne la perte irrémédiable des Event Rules non validées ou des structures de données modifiées, stockées uniquement dans la base de spécifications locale, dès que les Central Objects sont rafraîchis.
Une fois que le package d'Update a été déployé dans PD920Environnement standard de production dans JD Edwards EnterpriseOne 9.2. et que la promotion du projet est terminée, les protocoles automatisés de récupération de jeton restituent le jeton principal à la file d'attente du projet d'origine. Le développeur fonctionnel restaure alors l'archive .par dans DV920, intègre le delta provenant de la production et reprend ses développements sans perte de travail.
Génération de packages d'Update et préservation de la piste d'audit
Pendant une interruption de production, la tentation est grande de contourner l'assemblage de packages pour forcer le transfert direct des spécifications d'un pathcode à l'autre. C'est précisément avec ce raccourci que débute la corruption de mémoire. Les promotions d'urgence doivent impérativement être déployées par le biais d'Update Packages ciblés plutôt que par des transferts de spécifications ad hoc, afin de garantir que les fonctions C compilées génèrent des bibliothèques partagées cohérentes. La copie directe de spécifications laisse la mémoire d'exécution de l'Enterprise Server exécuter des binaires en décalage avec les spécifications tout juste mises à jour.
La génération d'un Update Package contenant exclusivement les objets impactés prend généralement entre 15 et 30 minutes sur une infrastructure moderne. Ce cycle de compilation génère de manière fiable le code source C, compacte les enregistrements de spécifications et met à jour les tables d'historique de déploiement du système dans la base Planner. Sauter cette étape crée un état fantôme sur l'Enterprise Server, garantissant presque à coup sûr l'échec ou l'écrasement inattendu de la modification d'urgence lors du prochain déploiement de package full programmé.
Le maintien de cette rigueur de packaging préserve les contrôles réglementaires au moment où la pression opérationnelle est à son comble. Chaque événement de promotion exécuté dans OMW enregistre automatiquement une entrée immuable dans les tables F9863 et F9864, consignant les ID utilisateurs, les horodatages, les pathcodes sources et les environnements cibles. Lorsque les équipes d'audit SOXLoi Sarbanes-Oxley imposant des règles strictes de contrôle interne et de traçabilité informatique. et IT externes examinent les livraisons hors cycle en production, ces enregistrements générés par le système prouvent la stricte séparation des tâches sans devoir s'appuyer sur des tickets de changement rédigés a posteriori.
Une fois le package déployé, finalisez la livraison proprement sur le niveau d'exécution. Server Manager doit être utilisé pour exécuter des redémarrages ciblés de kernels ou des bascules douces plutôt que des arrêts brutaux et non coordonnés du serveur, préservant ainsi les sessions des utilisateurs sur les environnements non impactés. Le rafraîchissement des seuls Call Object kernels concernés charge instantanément les nouvelles bibliothèques de fonctions, résolvant l'incident de production sans déconnecter les pistolets radio des entrepôts ni interrompre les sessions interactives en atelier.
Ingénierie d'un mécanisme de rollback exécutable
JDE OMW ne propose aucun mécanisme d'annulation en un seul clic par défaut. Dès qu'un Update Package est déployé dans PD920, les Central Objects et les spécifications d'exécution écrasent le pathcode de production de manière irréversible, à moins d'avoir conçu une voie de sortie avant d'appuyer sur le déclencheur. Compter sur un développeur pour rétro-concevoir une BSFN non validée ou reconstruire manuellement une définition APPL après l'échec d'un correctif d'urgence à minuit est le meilleur moyen de transformer un incident bref en une panne de plusieurs heures. Un mécanisme de rollback exécutable doit être entièrement préparé avant même le moindre déplacement de composant.
Avant de promouvoir le projet d'urgence hors de votre pathcode de test, votre CNC doit capturer l'état de référence d'origine. Extrayez l'état actuel de l'objet en production directement depuis PD920 dans un fichier par de sauvegarde, ou générez un package snapshot pré-déploiement via la gestion standard des packages. Placez ce code intact dans un projet miroir de rollback positionné à un statut OMW inactif, tel que le statut 26. Si les tests de validation post-déploiement échouent dans les quinze premières minutes, le CNC peut faire passer ce projet miroir directement au statut 38, réinstallant immédiatement l'état stable précédent sans se heurter à des conflits de verrouillage d'objets.
Déployer des packages de spécifications de remplacement sur les Enterprise Servers ne résout que la moitié du problème. Les moteurs HTML modernes mettent agressivement les métadonnées en cache, écrivant dans les tables de spécifications sérialisées F989999 et F989998. Tout plan d'urgence omettant la synchronisation des spécifications d'exécution expose les utilisateurs finaux à des formulaires corrompus ou à une logique métier obsolète sur la couche Java. Votre procédure de rollback doit imposer une purge explicite du cache via Server Manager sur tous les serveurs web de production, ou un redémarrage progressif programmé, forçant les instances JASJava Application Server : serveur hébergeant l'interface web pour les utilisateurs de JD Edwards. à vider les anciens enregistrements et à se re-sérialiser à partir de la version de référence restaurée.
Rétrofit post-déploiement et clôture du projet
La plupart des régressions de production liées à des correctifs d'urgence ne surviennent pas pendant l'incident lui-même, mais plusieurs semaines plus tard, lors d'une release de maintenance planifiée. Si votre équipe arrête le workflow dès que l'Update Package arrive dans PD920, vous laissez un écart de code non corrigé dans DV920 et PY920Environnement standard de test et de validation dans JD Edwards EnterpriseOne 9.2.. Dès que le projet suivant progresse dans le cycle de promotion, ces spécifications plus anciennes et non rétrofitées écraseront le hotfix en production, réactivant silencieusement le dysfonctionnement résolu pendant l'incident.
Un correctif d'urgence n'est techniquement achevé que lorsque la fusion descendante est terminée sur l'ensemble de vos pathcodes. Ouvrez le projet fonctionnel actif qui détient actuellement le jeton principal et lancez l'outil Visual Compare par rapport aux spécifications du projet d'urgence pour tout objet APPLApplication interactive JD Edwards conçue pour les utilisateurs finaux., UBEUniversal Batch Engine : programme de traitement par lots ou de reporting sous JD Edwards. ou NERNamed Event Rule : fonction métier rédigée en Event Rules puis convertie en code C. modifié. Pour les BSFN développées en langage C, effectuez un diff côte à côte sur les fichiers sources .c et .h directement dans le répertoire de développement DV920. L'intégration de la logique d'urgence dans la branche active garantit que la prochaine compilation de référence intégrera le hotfix au lieu de l'anéantir.
La dernière étape opérationnelle consiste à archiver formellement le conteneur. Passez le projet d'urgence OMW au Statut 01 (Terminé). Ce changement de statut applique trois contrôles obligatoires : il libère définitivement tout jeton secondaire ou en attente, retire les privilèges d'extraction et verrouille les journaux d'activité OMW dans F98210 et F98211 contre toute modification rétroactive. Tant que ce projet n'a pas atteint le Statut 01, votre piste d'audit reste exposée aux remarques de conformité et vos pathcodes demeurent dangereusement désynchronisés.
Sécuriser ce pipeline de promotion nécessite de traiter les correctifs urgents non pas comme des exceptions informelles, mais comme des branches scriptées et reproductibles au sein de votre gouvernance des changements. Auditez vos règles d'activité OMW et vos scripts de déploiement automatisé de packages avant que le prochain incident Sev-1 ne vous impose d'improviser dans l'urgence.