


Alle 02:00, quando un puntatore corrotto in una BSFNBusiness Function: modulo di codice in C o NER che esegue logica applicativa ed elaborazioni in JD Edwards. custom di allocazione inventario blocca la conferma di prelievo in tre centri di distribuzione, la reazione tipica è il panico. I technical lead affrontano enormi pressioni per bypassare l'Object Management WorkbenchOMW: lo strumento integrato di JD Edwards per il controllo delle versioni e la gestione del ciclo di vita del software., modificare le Event RulesIl linguaggio di scripting nativo di JD Edwards utilizzato per definire la logica di business e gestire gli eventi. direttamente in PD o copiare una .dll compilata manualmente direttamente su un Enterprise ServerServer principale che esegue i processi batch, la logica applicativa e le elaborazioni transazionali di JD Edwards.. Sembra una risoluzione da dieci minuti. In realtà, questi override speculativi avvelenano i Central ObjectsTabelle di database che fungono da repository centrale per le specifiche di programmazione in JD Edwards., iniettano specifiche anomale che restano invisibili e garantiscono che il successivo full packagePacchetto completo di deployment che ricompila e distribuisce l'intero insieme di applicazioni e oggetti del sistema. programmato faccia saltare di nuovo la produzione.
Il contenimento di un'emergenza non richiede anarchia tecnica. L'esecuzione di un workflow disciplinato di emergency fix in JDE OMW senza perdere il controllo consente alla coppia CNCConfigurable Network Computing: l'architettura tecnica e il ruolo di amministratore di sistema e middleware in JD Edwards.-sviluppatore di ramificare l'oggetto impattato, compilare un Update PackagePacchetto di installazione leggero che distribuisce solo gli oggetti modificati, senza ricompilare tutto il sistema. mirato e distribuire una correzione verificata tipicamente entro 60-90 minuti. Questo protocollo protegge i tokenMeccanismo di blocco esclusivo in OMW che consente a un solo sviluppatore alla volta di modificare un oggetto. di sviluppo attivi gestiti dai team a metà sprint in DV920L'ambiente standard di sviluppo (Development) in JD Edwards EnterpriseOne versione 9.2., mantiene una traccia elettronica verificabile per la compliance e garantisce che l'hotfixAggiornamento urgente applicato direttamente su un sistema per risolvere un bug critico e imprevisto. sopravviva intatto ai successivi package build.
Il Rischio Architetturale degli Hotfix di Produzione
Sotto la pressione di un incidente Sev-1Severity 1: livello massimo di criticità per un incidente che causa l'interruzione completa dei processi aziendali., la scorciatoia più rapida è spesso la più catastrofica: aggiornare i Central Objects direttamente via SQL o iniettare manualmente record di spec. Il bypass dell'Object Management Workbench corrompe immediatamente i record dell'Object Master (F9860) e dell'Object Librarian status (F9861). Nel momento in cui una riga della F9861 perde la sincronizzazione con le tabelle relazionali dei Central Objects, la parità tra i pathcodePuntatore che identifica la collocazione fisica dei sorgenti e delle specifiche centrali di un ambiente. svanisce. EnterpriseOne perde l'integrità referenziale che stabilisce quale ambiente detenga la versione approvata di quel componente.
La modalità di guasto immediata colpisce direttamente gli Enterprise Server. La modifica della logica di una BSFN senza una distribuzione coordinata delle spec crea una discrepanza tra le DLL runtime compilate (o shared object su Linux) e le spec serializzate memorizzate nella cache dei processi kernel. Questo disallineamento strutturale causa un disallineamento di memoria, mandando in crash il Call Object KernelProcesso server di JD Edwards che esegue le Business Function richieste dalle sessioni utente o dai batch. e generando una cascata di processi zombie che abbattono le sessioni interattive degli utenti. Una modifica non controllata in C per correggere l'elaborazione degli ordini può mandare rapidamente fuori uso un'intera istanza di Enterprise Server.
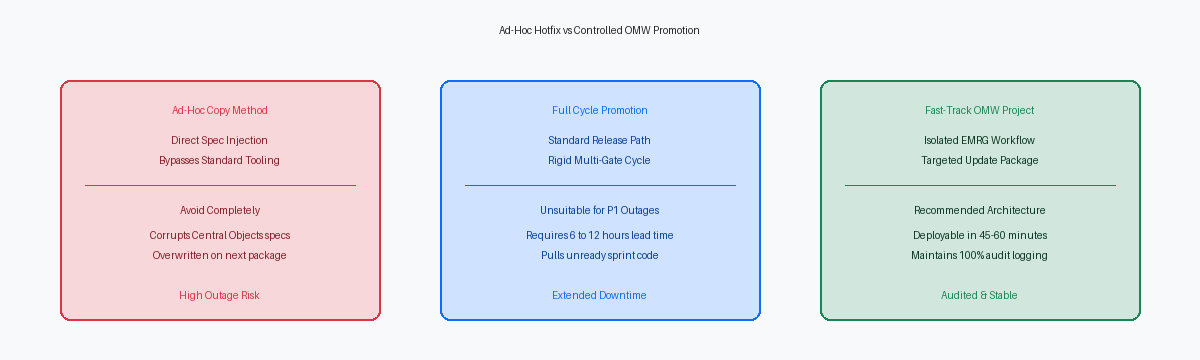
Anche se il server rimane attivo, le modifiche fuori standard garantiscono un disastro differito. Il successivo full package programmato compila specifiche pulite rigorosamente dal repository Central Objects mappato nell'ambiente di deployment. Qualsiasi binario sostituito manualmente su un Enterprise Server o qualsiasi definizione di tabella modificata al di fuori di OMW viene silenziosamente sovrascritta. L'hotfix scompare senza lasciare traccia nell'audit trail, ripristinando il difetto di produzione durante una normale finestra di manutenzione.
La pressione operativa non può esimere un'organizzazione dalla fisica dei sistemi. Un percorso di emergenza controllato richiede un'incrollabile disciplina del repository a percorso unico, in cui ogni byte trasferito in produzione attraversa la convalida standard dei token, avanzamenti di stato tracciati e Update Package verificabili.
Configurazione di un Branch di Progetto Controllato e Isolato
Quando si verifica un blocco di produzione di severità 1, gli sviluppatori tendono per riflesso a eseguire il checkoutOperazione che scarica una copia locale modificabile di un oggetto dal repository centrale alla workstation dello sviluppatore. dell'oggetto incriminato all'interno di qualsiasi progetto di sviluppo attivo abbiano già aperto. Questa singola abitudine contamina regolarmente gli hotfix con codice di sprint non ancora rilasciato. È fondamentale imporre una separazione netta stabilendo un container di progetto isolato con una convenzione di denominazione rigorosa, come EMRG_[Issue#]. Questa segregazione garantisce che il payload urgente rimanga completamente scollegato dai cicli di rilascio pianificati, eliminando il rischio che modifiche funzionali non collaudate scivolino in produzione.
La disciplina dell'ambito all'interno di questo container deve essere assoluta. Il progetto deve contenere esclusivamente i singoli artefatti direttamente responsabili della correzione: in genere una Business Function C isolata, un trigger di tabella o un'applicazione batch. Se un tecnico deve ispezionare strutture dati chiamanti o form applicativi correlati, tali definizioni devono rimanere intatte nel pathcode. Trascinare dipendenze periferiche nel progetto attivo incentiva check-in accidentali, trasformando una patch mirata a singolo oggetto in un rilascio incontrollato.
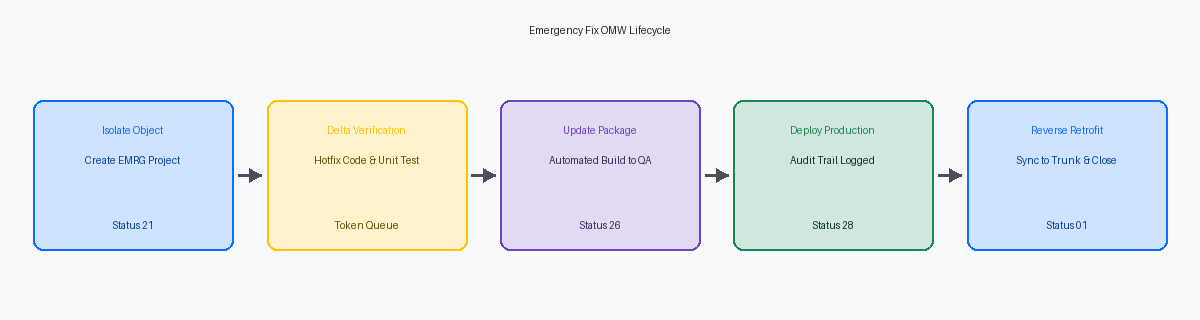
La gestione della velocità richiede OMW activity rulesRegole di configurazione che governano i passaggi di stato e le azioni ammesse durante la promozione dei progetti. su misura, mappate specificamente per scenari urgenti, aggirando i normali gate di sviluppo pluridisciplinari. Anziché forzare il progetto attraverso l'intera progressione dallo Status 21 fino allo Status 26, si definisce un percorso di transizione esplicito che avanza dallo Status 21 direttamente a una fase di test rapida allo Status 25, e poi direttamente allo Status 28 per il trasferimento nei Central Objects - PD. Il project owner deve imporre ruoli di progetto obbligatori all'interno di questo percorso. Lo sviluppatore che corregge il codice non può ricoprire il ruolo di approvazione o deployment; la segregazione dei compiti imposta dal sistema tra programmatore e CNC deve rimanere attiva anche durante un incident bridge notturno.
Gestione dei Token Preservando il Work in Progress
I blocchi di produzione raramente attendono la conclusione di uno sprint. Quando una BSFN critica per l'inserimento ordini si blocca a fine mese, quell'oggetto è quasi certamente estratto in DV920 per un'implementazione di funzionalità in corso. Rilasciare bruscamente quel token per liberare una corsia preferenziale invalida le modifiche al codice in lavorazione presenti e non compilate nel pathcode di sviluppo. EnterpriseOne traccia la proprietà del checkout e la sequenza della coda all'interno della tabella F98611Tabella di sistema di JD Edwards che memorizza lo stato dei token e la coda delle richieste di modifica per ciascun oggetto.; forzare manualmente questi lock corrompe le spec del lavoro in corso e interrompe la sincronizzazione tra sviluppatori.
I workflow di emergenza stabili fanno affidamento sulla coda nativa dei token mantenuta all'interno della F98611. Il team dell'intervento urgente inserisce il proprio progetto nella coda o attiva un controllo di ereditarietà, consentendo agli sviluppatori di eseguire un checkout senza detenere il primary tokenIl token principale che concede l'autorizzazione esclusiva a trasferire le modifiche nel repository centrale.. Ciò consente un triage mirato su specifiche corrispondenti alla produzione senza interrompere la relazione tra il feature branch attivo e il repository centrale condiviso.
Quando l'intervento sul codice richiede un trasferimento assoluto del token, il responsabile CNC deve intervenire con misure di salvaguardia rigorose. Prima di rilasciare il token al progetto di emergenza, lo sviluppatore attivo deve eseguire un export delta esplicito del proprio lavoro in corso in un archivio locale di specifiche .parFormato compresso proprietario di JD Edwards utilizzato per archiviare ed esportare le specifiche degli oggetti OMW.. Omettere questo passaggio significa che le Event Rules non committate o le strutture dati modificate archiviate solo nel database locale delle spec svaniranno nel momento in cui i Central Objects verranno aggiornati.
Una volta che l'Update Package di emergenza viene rilasciato in PD920L'ambiente di produzione (Production) in JD Edwards EnterpriseOne versione 9.2, contenente i dati e le transazioni reali. e la promozione del progetto è completata, i protocolli automatizzati di recupero dei token restituiscono il token primario alla coda del progetto originale. Lo sviluppatore della funzionalità ripristina l'archivio .par in DV920, unisce il delta di produzione in arrivo e continua lo sviluppo senza perdere lavoro.
Build di Update Package e Conservazione dell'Audit Trail
Durante un'interruzione della produzione, la tentazione è quella di bypassare l'assemblaggio dei package e forzare le specifiche direttamente tra i pathcode. È proprio con questa scorciatoia che inizia la corruzione della memoria. Le promozioni di emergenza devono essere distribuite tassativamente tramite Update Package mirati anziché trasferimenti ad-hoc di spec, garantendo che le Business Function C compilate generino librerie condivise coerenti. Le copie dirette delle spec lasciano la memoria runtime dell'Enterprise Server a eseguire binari non allineati rispetto alle specifiche appena aggiornate.
La compilazione di un Update Package contenente esclusivamente gli oggetti interessati richiede in genere dai 15 ai 30 minuti su un'infrastruttura moderna. Questo ciclo di compilazione genera in modo affidabile i sorgenti C, impacchetta i record delle spec e aggiorna le tabelle storiche di deployment del sistema nel database Planner. Saltare questo passaggio crea uno stato di "ghost build" sull'Enterprise Server, garantendo quasi matematicamente che il successivo deployment di un full package programmato fallirà o sovrascriverà inaspettatamente la modifica di emergenza.
Il mantenimento di questa disciplina di packaging preserva la conformità normativa nei momenti di massima pressione operativa. Ogni evento di promozione eseguito in OMW registra automaticamente una voce immutabile di log nelle tabelle F9863 e F9864, acquisendo ID utente, timestamp, pathcode sorgente e ambienti di destinazione. Quando i team esterni di audit SOXSarbanes-Oxley Act: normativa che impone severi controlli interni e tracciabilità informatica sui sistemi contabili e gestionali. e IT esaminano i rilasci di produzione fuori ciclo, queste registrazioni generate dal sistema certificano la separazione dei compiti autorizzata, senza dover dipendere da change ticket redatti a posteriori.
Una volta distribuito il package, completare il rilascio in modo pulito sul livello runtime. È necessario utilizzare Server ManagerInterfaccia web centralizzata di Oracle JD Edwards per monitorare, configurare e riavviare le istanze server. per eseguire ricicli mirati dei kernel o soft bounce anziché arresti non coordinati del server, preservando le sessioni utente negli ambienti non impattati. Lo svuotamento esclusivo dei Call Object kernel interessati carica istantaneamente le nuove librerie di Business Function, risolvendo il problema di produzione senza far cadere i terminali di magazzino attivi o le sessioni interattive dell'officina.
Progettazione di un Meccanismo di Rollback Eseguibile
JDE OMW nativo non offre un'operazione di annullamento con un singolo clic. Una volta che un Update Package viene distribuito in PD920, i Central Objects e le specifiche di runtime sovrascrivono il pathcode di produzione in modo irreversibile, a meno che non sia stata pianificata una via di fuga prima di procedere. Affidarsi a uno sviluppatore per ricostruire a ritroso una BSFN non committata o ricreare manualmente una definizione APPLOggetto applicativo interattivo di JD Edwards composto da interfacce utente (form) e logica associata. dopo il fallimento di un fix notturno di emergenza è il modo più rapido per trasformare brevi incidenti in interruzioni di molte ore. Un meccanismo di rollback eseguibile deve essere completamente predisposto prima di movimentare il payload.
Prima di promuovere il progetto di emergenza fuori dal pathcode di test, il CNC deve salvare la baseline originale. È necessario esportare lo stato corrente dell'oggetto di produzione direttamente da PD920 in un par file di rollback, oppure creare un package snapshot pre-deployment tramite la gestione standard dei package. Questo codice intatto va inserito in un progetto di rollback speculare posizionato a uno stato OMW inattivo, come lo Status 26. Se gli smoke testTest preliminare rapido per verificare che le funzionalità basilari di un'applicazione funzionino dopo un aggiornamento. post-rilascio falliscono entro i primi quindici minuti, il CNC può far avanzare direttamente quel progetto speculare allo Status 38, ripristinando immediatamente lo stato funzionante precedente senza scontrarsi con conflitti di checkout e checkin.
Distribuire package di spec sostitutivi sugli Enterprise Server risolve solo metà del problema. I motori HTML moderni memorizzano i metadati nella cache in modo aggressivo, scrivendo nelle tabelle F989999 e F989998 delle spec serializzateMetadati applicativi generati e memorizzati in tabelle di database ottimizzate per l'accesso rapido da parte dei web server.. Qualsiasi piano di emergenza che ometta la sincronizzazione delle specifiche di runtime garantisce che gli utenti finali incontreranno form corrotti o logiche di business obsolete nel layer Java. Il playbook di rollback deve prevedere uno svuotamento esplicito della cache tramite Server Manager su tutti i web server di produzione, oppure un riavvio progressivo programmato, costringendo le istanze JASJava Application Server: il componente runtime che ospita l'interfaccia web e traduce le spec per gli utenti. a eliminare i vecchi record di spec e a riserializzarli dalla baseline ripristinata.
Retrofitting Post-Deployment e Chiusura del Progetto
La maggior parte delle regressioni in produzione legate agli emergency fix non si verifica durante l'incidente stesso, ma diverse settimane dopo, durante un normale rilascio di manutenzione. Se il team interrompe il workflow nel momento esatto in cui l'Update Package raggiunge PD920, lascia un disallineamento di codice non integrato in DV920 e PY920L'ambiente di collaudo e accettazione (Prototype) in JD Edwards EnterpriseOne versione 9.2.. Non appena il successivo progetto pianificato avanza nella pipeline, quelle specifiche precedenti e non allineate sovrascriveranno l'hotfix in produzione, resuscitando silenziosamente il difetto risolto durante l'incidente.
Un emergency fix è tecnicamente incompleto finché non viene completato il merge a ritroso (retrofitting) su tutti i pathcode. Aprire il progetto della funzionalità attivo che detiene il primary token e avviare lo strumento Visual CompareStrumento grafico di JD Edwards per confrontare visivamente differenze di specifiche ed Event Rules tra versioni o ambienti. confrontando le specifiche del progetto di emergenza per qualsiasi oggetto APPL, UBEUniversal Batch Engine: il motore per l'esecuzione di processi batch, elaborazioni massive e report in JD Edwards. o NERNamed Event Rule: funzione di business scritta con il linguaggio di Event Rules anziché in codice C. modificato. Per le BSFN custom in linguaggio C, eseguire un diff a schermo diviso sui file sorgente .c e .h direttamente all'interno della directory di sviluppo di DV920. L'integrazione della logica di emergenza nel feature branch attivo garantisce che la successiva build di baseline includa l'hotfix anziché cancellarlo.
L'ultimo passaggio operativo consiste nella dismissione formale del container. Far avanzare il progetto OMW di emergenza allo Status 01 (Complete). Questo avanzamento di stato attiva tre controlli obbligatori: rilascia in modo permanente qualsiasi token secondario o in coda, revoca i privilegi di checkout e blocca i log di attività OMW nelle tabelle F98210 e F98211 contro modifiche retroattive. Finché il progetto non raggiunge lo Status 01, l'audit trail rimane esposto a contestazioni di compliance e i pathcode restano pericolosamente disallineati.
Rendere resiliente questa pipeline di promozione richiede di trattare i fix urgenti non come eccezioni ad-hoc, ma come rami programmabili e ripetibili all'interno del framework aziendale di change management. Verificare le OMW activity rules e gli script automatizzati di deployment dei package prima che il prossimo evento Sev-1 imponga decisioni non pianificate.
