


Às 02:00, quando um ponteiro corrompido em uma BSFNBusiness Function: componente de código que executa regras de negócio no JD Edwards. customizada de alocação de estoque paralisa a confirmação de separação em três centros de distribuição, a reação padrão é o pânico. Líderes técnicos enfrentam imensa pressão para contornar o Object Management WorkbenchFerramenta central de controle de versão, gerenciamento de projetos e ciclo de vida de objetos no JDE., editar regras de evento diretamente em PDProduction: o ambiente de produção operacional do JD Edwards EnterpriseOne. ou copiar uma .dll compilada manualmente direto para o enterprise server. Parece um resgate de dez minutos. Na realidade, intervenções especulativas corrompem os Central ObjectsRepositório de banco de dados que armazena as especificações de código e telas de cada ambiente., injetam especificações fantasmas que permanecem invisíveis e garantem que o próximo full packagePacote completo que compila e distribui todos os objetos do sistema para servidores e clientes. programado derrube a produção novamente.
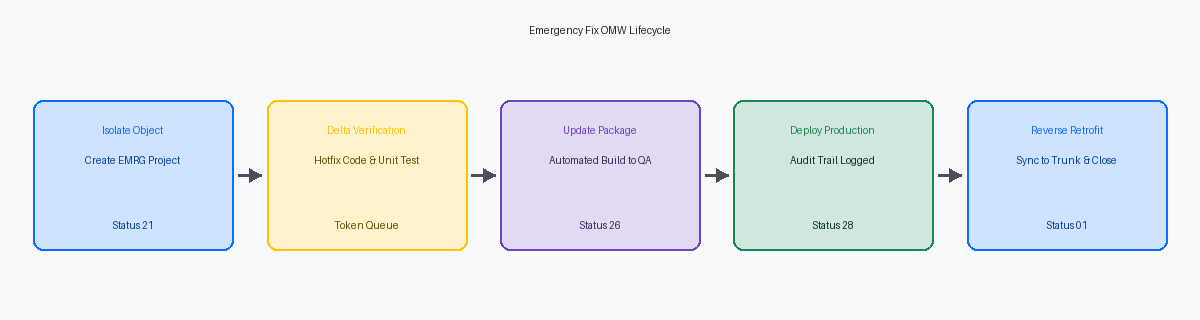
A contenção de emergência não exige anarquia técnica. A execução de um fluxo disciplinado de correção de emergência no JDE OMW sem perder o controle permite que uma dupla de CNCConfigurable Network Computing: arquitetura e perfil de administração de sistemas e infraestrutura do JD Edwards. e desenvolvedor crie um branch do objeto impactado, gere um update packagePacote incremental que compila e implanta apenas os objetos modificados, permitindo entregas rápidas. direcionado e faça o deploy de uma correção verificada normalmente dentro de 60 a 90 minutos. Esse protocolo protege tokensMecanismo de bloqueio que garante posse exclusiva para alteração de um objeto no OMW. de desenvolvimento ativos mantidos por equipes no meio de sprints em DV920Ambiente padrão de desenvolvimento (Development) no JD Edwards EnterpriseOne release 9.2., preserva uma trilha eletrônica auditável para conformidade e garante que o hotfix sobreviva intacto a builds de pacotes subsequentes.
O Risco Arquitetural de Hotfixes em Produção
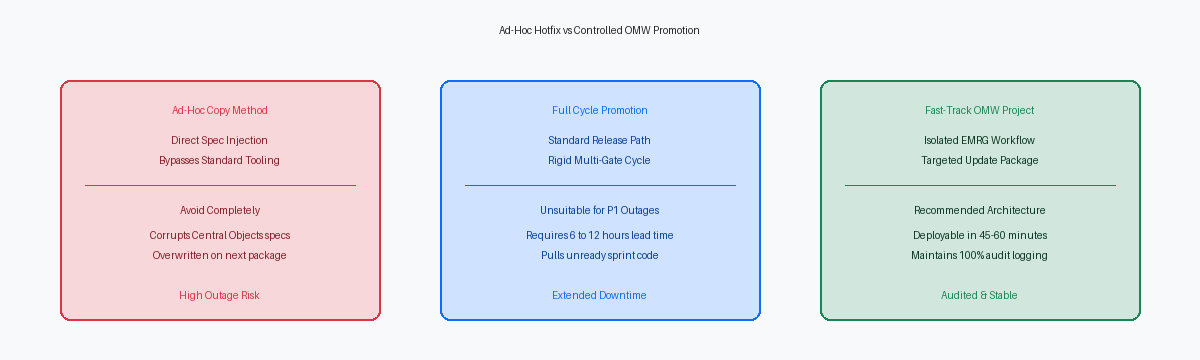
Sob a pressão de um incidente Sev-1Severidade 1: incidente crítico de máxima urgência que causa indisponibilidade total das operações de negócio., o atalho mais rápido costuma ser o mais catastrófico: atualizar Central Objects diretamente via SQL ou injetar registros de spec manualmente. Contornar o Object Management Workbench quebra imediatamente os registros do object master (F9860) e do object librarian status (F9861). No momento em que uma linha da F9861 perde a sincronia com as tabelas relacionais de Central Objects, a paridade de pathcodesConjunto de ponteiros de diretórios e bancos de dados que definem o ambiente JDE. desaparece. O EnterpriseOne perde a integridade referencial que define qual ambiente detém a versão aprovada daquele componente.
O modo imediato de falha atinge em cheio os enterprise servers. Modificar a lógica de uma BSFN sem uma entrega coordenada de specs cria uma incompatibilidade entre DLLs de runtime compiladas — ou shared objects no Linux — e as specs serializadas em cache pelos processos de kernel. Esse desalinhamento estrutural corrompe a memória, derruba o Call Object KernelProcesso de servidor responsável por carregar e executar funções de negócio (BSFNs) na memória. e gera processos zumbis em cascata que encerram sessões de usuários interativos. Uma modificação não gerenciada em C para corrigir o processamento de pedidos rapidamente derruba uma instância inteira do enterprise server.
Mesmo que o servidor permaneça de pé, alterações fora do padrão garantem um desastre postergado. O próximo build agendado de full package compila specs limpas estritamente a partir do repositório Central Objects mapeado no ambiente de deployment. Qualquer binário trocado manualmente em um enterprise server ou definição de tabela alterada fora do OMW é silenciosamente sobrescrita. O hotfix desaparece sem deixar trilha de auditoria, ressuscitando o defeito em produção durante uma janela de manutenção rotineira.
A pressão operacional não isenta uma organização da física do sistema. Um caminho de emergência controlado exige disciplina inegociável de repositório de via única, onde cada byte promovido para produção passa por validação padrão de token, avanço de status registrado em log e update packages auditáveis.
Configurando um Branch de Projeto Isolado e Controlado
Quando ocorre uma indisponibilidade crítica de severidade 1 em produção, os desenvolvedores instintivamente fazem o checkout do objeto problemático no projeto de desenvolvimento ativo que já estiver aberto. Esse simples hábito contamina rotineiramente os hotfixes com código não liberado da sprint. Imponha uma separação rigorosa estabelecendo um contêiner de projeto isolado com uma convenção de nomenclatura estrita, como EMRG_[Issue#]. Essa segregação garante que a alteração urgente permaneça totalmente desvinculada dos ciclos de release programados, eliminando o risco de mudanças funcionais não homologadas irem para produção.
A disciplina de escopo dentro desse contêiner deve ser absoluta. O projeto deve conter exclusivamente os um ou dois artefatos diretamente responsáveis pela correção — normalmente uma C business function isolada, um table trigger ou um batch application. Se um engenheiro precisar inspecionar data structures chamadoras ou telas de aplicações relacionadas, essas definições devem permanecer intocadas no pathcode. Incluir dependências periféricas no projeto ativo abre margem para check-ins acidentais, transformando um patch pontual de um único objeto em uma implantação descontrolada.
Gerenciar a velocidade exige OMW activity rulesRegras configuradas que automatizam transferências de objetos e ações quando um projeto muda de status. sob medida, mapeadas especificamente para cenários urgentes, contornando aprovações padrão de desenvolvimento que levariam semanas. Em vez de forçar o projeto por toda a progressão do Status 21 ao Status 26, estabeleça um caminho de transição explícito que avance do Status 21 direto para uma fase de testes acelerada no Status 25, e em seguida diretamente para o Status 28 para transferência para Central Objects - PD. O responsável pelo projeto deve impor papéis obrigatórios dentro desse fluxo. O desenvolvedor que corrige o código não pode ter a permissão de aprovação ou de deploy; a segregação de funções imposta pelo sistema entre programador e CNC deve ser mantida mesmo durante uma ponte de crise na madrugada.
Gerenciamento de Tokens Preservando o Trabalho em Andamento
Paradas em produção raramente esperam o encerramento de uma sprint. Quando uma BSFN crítica de entrada de pedidos falha no fechamento do mês, esse objeto quase certamente está em checkout em DV920 para uma melhoria em andamento. Liberar abruptamente esse token para abrir caminho para a urgência invalida alterações de código incompletas e não compiladas no pathcode de desenvolvimento. O EnterpriseOne rastreia a posse de checkouts e a fila de espera na tabela F98611Tabela do Object Librarian que rastreia os tokens e filas de checkout de cada objeto.; passar por cima desses bloqueios manualmente corrompe specs de trabalhos em andamento e quebra a sincronização entre desenvolvedores.
Fluxos de emergência estáveis dependem da fila nativa de tokens mantida dentro da F98611. A equipe da correção urgente posiciona seu projeto na fila ou aciona uma verificação de herança, permitindo que os desenvolvedores executem um checkout sem deter o token primário. Isso viabiliza uma triagem direcionada contra specs equivalentes às de produção sem romper o vínculo entre o branch da funcionalidade ativa e o repositório central compartilhado.
Quando a intervenção no código exige uma transferência absoluta de token, o líder CNC deve agir com salvaguardas disciplinares. Antes de liberar o token para o projeto de emergência, o desenvolvedor ativo deve executar uma exportação delta explícita do seu trabalho em andamento para um arquivo compactado local de especificações (.par)Arquivo de especificações compactadas do JDE para exportação e restauração pontual de objetos.. Ignorar essa etapa significa que Event Rules não comitadas ou data structures modificadas armazenadas apenas no banco de dados local de specs desaparecerão no momento em que os Central Objects forem atualizados.
Assim que o update package de emergência entra em PD920 e a promoção do projeto é concluída, protocolos automatizados de recuperação de token devolvem o token primário para a fila do projeto original. O desenvolvedor da funcionalidade restaura o arquivo .par em DV920, mescla o delta que veio de produção e retoma o desenvolvimento sem perda de trabalho.
Builds de Update Package e Preservação da Trilha de Auditoria
A tentação durante uma queda em produção é ignorar a montagem de pacotes e forçar especificações diretamente entre pathcodes. É nesse atalho que a corrupção de memória começa. Promoções de emergência devem ser feitas estritamente via Update Packages direcionados, e não por transferências avulsas de specs, garantindo que as C business functions compiladas gerem bibliotecas compartilhadas consistentes. Cópias diretas de specs deixam a memória de runtime do enterprise server executando binários desalinhados com as especificações recém-atualizadas.
A compilação de um Update Package contendo exclusivamente os objetos impactados leva tipicamente de 15 a 30 minutos em uma infraestrutura moderna. Esse ciclo compila com segurança o código-fonte em C, empacota os registros de spec e atualiza as tabelas de histórico de deployment do sistema no banco de dados Planner. Pular essa etapa cria um estado fantasma de build no enterprise server, praticamente garantindo que o próximo deploy agendado de full package falhe ou sobrescreva a alteração de emergência de forma inesperada.
Manter essa disciplina de empacotamento preserva os controles regulatórios no momento de maior pressão operacional. Cada evento de promoção executado no OMW grava automaticamente um registro imutável nas tabelas F9863Tabela do JDE que armazena o histórico detalhado de logs e ações em projetos do OMW. e F9864, capturando IDs de usuário, carimbos de data/hora, pathcodes de origem e ambientes de destino. Quando equipes externas de auditoria SOX e de TI analisam liberações em produção fora do ciclo normal, essas entradas geradas pelo sistema comprovam a segregação autorizada de funções, sem depender de chamados preenchidos retroativamente.
Assim que o deploy do pacote for concluído, finalize a liberação de forma limpa na camada de runtime. O Server ManagerConsole web centralizado para administração, monitoramento e controle de instâncias no JDE. deve ser usado para executar reciclagens direcionadas de kernels ou soft bounces em vez de encerramentos abruptos de servidores, preservando as sessões dos usuários nos ambientes não impactados. Esvaziar apenas os Call Object kernels relevantes carrega as novas bibliotecas de business functions instantaneamente, solucionando o problema em produção sem desconectar coletores de dados nos armazéns ou sessões interativas no chão de fábrica.
Projetando um Mecanismo Executável de Rollback
O JDE OMW nativo não oferece uma operação de desfazer com um único clique. Depois que um update package é aplicado em PD920, os central objects e as especificações de runtime sobrescrevem o pathcode de produção de forma irreversível, a menos que você tenha planejado uma rota de saída antes de acionar a promoção. Confiar que um desenvolvedor fará engenharia reversa de uma BSFN não comitada ou reconstruirá manualmente a definição de uma APPLInteractive Application: aplicação interativa de telas e formulários para o usuário final no JDE. após a falha de um hotfix de madrugada é o caminho certo para transformar incidentes curtos em paralisações de muitas horas. Um mecanismo de rollback executável deve estar totalmente preparado antes que o pacote seja promovido.
Antes de promover o projeto de emergência para fora do pathcode de testes, o CNC deve capturar o baseline intocado. Extraia o estado atual do objeto em produção diretamente de PD920 para um par fileArquivo de especificações empacotadas do JDE que armazena o snapshot original do objeto. de rollback, ou gere um pacote de snapshot pré-deploy pelo gerenciamento padrão de pacotes. Guarde esse código íntegro em um projeto espelho de rollback configurado em um status inativo do OMW, como o status 26. Se os testes rápidos pós-deploy falharem nos primeiros quinze minutos, o CNC pode avançar esse projeto espelho diretamente para o status 38, restaurando o último estado estável imediatamente sem entrar em conflitos de checkout e checkin.
O deploy de pacotes de spec de substituição para os Enterprise servers resolve apenas metade do problema. Mecanismos HTML modernos fazem cache agressivo de metadados, gravando nas tabelas de specs serializadas F989999 e F989998. Qualquer plano de emergência que ignore a sincronização de specs em runtime garantirá que os usuários finais encontrem telas corrompidas ou lógica de negócios desatualizada na camada Java. Seu playbook de rollback deve exigir a limpeza explícita de cache via Server Manager em todos os servidores web de produção, ou uma reinicialização progressiva programada, forçando as instâncias JASJava Application Server: servidor web responsável por renderizar as interfaces gráficas HTML do JDE. a descartar registros antigos de spec e resserializar a partir do baseline restaurado.
Retrofitting Pós-Deploy e Fechamento do Projeto
A maioria das regressões em produção ligadas a correções de emergência não ocorre durante o incidente em si; elas acontecem semanas depois, durante uma release de manutenção rotineira. Se a equipe encerrar o fluxo de trabalho assim que o update package entrar em PD920, você deixará um delta de código não incorporado em DV920 e PY920. No instante em que o próximo projeto agendado avançar pelo pipeline, essas specs mais antigas e sem retrofitting sobrescreverão o hotfix em Produção, ressuscitando silenciosamente o defeito corrigido no incidente.
Uma correção de emergência está tecnicamente incompleta até que a mesclagem reversa (retrofitting) seja finalizada em todos os pathcodes. Abra o projeto da funcionalidade ativa que detém o token primário e inicie a ferramenta Visual CompareUtilitário gráfico do JDE para inspecionar e mesclar diferenças de código entre versões de objetos. contra as specs do projeto de emergência para quaisquer objetos APPL, UBEUniversal Batch Engine: programas de processamento em lote e relatórios no JD Edwards. ou NERNamed Event Rules: lógica de negócios criada via regras de evento e compilada em C. modificados. Para BSFNs customizadas em linguagem C, execute um diff lado a lado nos arquivos-fonte .c e .h diretamente dentro do diretório de desenvolvimento do DV920. A integração da lógica de emergência no branch ativo da funcionalidade garante que o próximo build de baseline incorpore o hotfix em vez de apagá-lo.
A última etapa operacional é a desativação formal do contêiner. Avance o projeto de emergência do OMW para o Status 01 (Complete). Esse avanço de status executa três controles obrigatórios: libera em definitivo quaisquer tokens secundários ou na fila, remove privilégios de checkout e bloqueia os logs de atividade do OMW na F98210 e F98211 contra alterações retroativas. Até que o projeto atinja o Status 01, sua trilha de auditoria permanecerá exposta a questionamentos de conformidade, e seus pathcodes estarão perigosamente fora de sincronia.
Fortalecer esse pipeline de promoção requer tratar correções urgentes não como exceções improvisadas, mas como branches estruturados e repetíveis dentro da sua estrutura principal de change management. Audite suas OMW activity rules e scripts de deployment automatizado de pacotes antes que o próximo evento Sev-1 exija uma decisão sem planejamento.
