Sprache auswählen


- Details
- By Vincenzo Caserta
- Kategorie: UBE Development
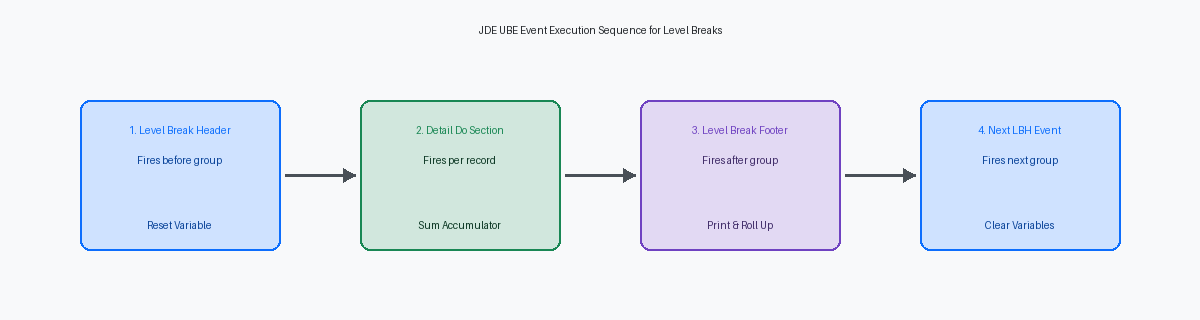
Eine fehlerfreie Kompilierung der Event Rules (ER)Die proprietäre Programmiersprache von JD Edwards, mit der Geschäftslogik für Berichte und interaktive Anwendungen erstellt wird. im Report Design AssistantDas visuelle Entwicklungswerkzeug innerhalb von JD Edwards zur Erstellung und Anpassung von Berichten (UBEs). garantiert zwar die syntaktische Gültigkeit, sagt jedoch nichts über die mathematische Integrität aus. Bei ausgereiften 9.2-Builds, die Batch-Prozesse über mehr als 100.000 Hauptbuch- oder Bestandszeilen ausführen, löst ein falsch platzierter Zeitpunkt für den Variablen-Reset niemals einen Laufzeitfehler oder eine C-BSFNIn C geschriebene Geschäftsfunktionen (Business Functions) in JD Edwards, die für komplexe oder hochperformante Berechnungen genutzt werden.-Speicherverletzung aus. Stattdessen wird die UBEUniversal Batch Engine. Ein im Hintergrund ausgeführter Batch-Job, Report oder Massenverarbeitungsprozess in JD Edwards. mit dem Status 60 abgeschlossen, während im Hintergrund unbemerkt fehlerhafte Zwischensummen (Off-by-One-FehlerEin klassischer Logikfehler, bei dem eine Schleife oder Berechnung genau einmal zu oft oder zu wenig ausgeführt wird.) oder doppelt gezählte Gesamtsummen über Sektionsgrenzen hinweg generiert werden.
- Details
- By Vincenzo Caserta
- Kategorie: UBE Development
In JDE-Unternehmensumgebungen, in denen zentrale Hauptbuchtabellen wie F0911 oder Transaktionsbücher wie F4111 auf über 20 Millionen Zeilen anwachsen, kann eine einzige schlecht strukturierte RDAReport Design Aid – das Entwicklungswerkzeug in JD Edwards zur Erstellung und Gestaltung von Berichten und Batch-Prozessen.-Klausel einen Batch-Lauf von unter einer Minute in einen mehrstündigen Warteschlangen-Engpass verwandeln. Wenn die nächtlichen Batch-Zeitfenster überschritten werden, geben Infrastrukturteams meist den CNCConfigurable Network Computing – die Systemarchitektur und Administrationstechnologie von JD Edwards zur Verwaltung von Umgebungen und Ressourcen.-Warteschlangen-Zuweisungen die Schuld oder fordern Upgrades des Datenbank-Arbeitsspeichers. In der Realität resultiert die überwiegende Mehrheit der lang laufenden benutzerdefinierten UBEsUniversal Batch Engines – Hintergrundprozesse oder Batch-Jobs in JD Edwards, die für Datenverarbeitung, Berichte und Massenoperationen verwendet werden. – oft drei Viertel oder mehr – direkt aus ineffizientem SQLStructured Query Language – die Standardsprache zur Abfrage und Verwaltung von Daten in relationalen Datenbanken., das durch fehlerhafte Selektionskriterien generiert wird.
- Details
- By Vincenzo Caserta
- Kategorie: UBE Development
Wenn Finanz- oder Supply-Chain-Teams einen täglichen automatisierten Abgleich zwischen Standard-Ledger-Tabellen wie der F0911Die zentrale Hauptbuch-Tabelle (Account Ledger) in JD Edwards, die alle Finanztransaktionen enthält. und Drittsystemen fordern, schreiben Datenbankadministratoren oft reflexartig externe SQL-Skripte oder Datenbank-Trigger. Dieser Ansatz geht regelmäßig nach hinten los: Er umgeht die Lifecycle-Kontrollen der JDE Object Management Workbench (OMW)Das integrierte Versionskontroll- und Änderungsmanagementsystem von JD Edwards für Softwareobjekte., ignoriert Sicherheitsregeln und birgt das Risiko, aktive Transaktionstabellen während der Haupt-Batch-Zeiten zu sperren.
- Details
- By Vincenzo Caserta
- Kategorie: UBE Development
Ich auditiere regelmäßig benutzerdefinierte Berichtsumgebungen, in denen ein erheblicher Teil des Event-RulesDie proprietäre Skriptsprache von JD Edwards zur Definition von Geschäftslogik in Anwendungen und Berichten.-Codes – oft 30 % bis 40 % – aus identischer Logik besteht, die über drei oder vier bedingte Sektionen hinweg kopiert wurde. Entwickler klonen eine Sektion nur, um das visuelle Layout für eine bestimmte Filiale (Branch/PlantEine organisatorische Einheit in JD Edwards, die typischerweise eine Filiale, ein Lager oder eine Produktionsstätte darstellt.) oder einen Auftragstyp zu ändern, und duplizieren dabei Hunderte von Zeilen komplexer Bestands- oder Steuerberechnungs-ERAbkürzung für Event Rules, die integrierte Skriptsprache in JD Edwards.. Wenn sich die Geschäftsregeln unweigerlich ändern, patcht ein Entwickler Sektion A, vergisst Sektion B und verursacht eine schleichende Datenkorruption, die erst nach Wochen in der Produktion bemerkt wird.
- Details
- By Vincenzo Caserta
- Kategorie: UBE Development
In ausgereiften EnterpriseOne 9.2-Umgebungen resultiert ein erheblicher Teil der Produktions-Batch-Fehler – oft 30 % bis 40 % – aus benutzerdefinierten UBEsUniversal Batch Engine. Batch-Jobs oder Berichte in JD Edwards, die im Hintergrund auf dem Server ausgeführt werden., die auf lokalen Entwicklungs-Clients fehlerfrei liefen. Entwickler validieren Berichte routinemäßig mit einem kleinen DVDevelopment (Entwicklungsumgebung). Die primäre Umgebung für Entwickler zum Erstellen und Testen von Code in JD Edwards.-Datensatz von 1.000 bis 2.000 Zeilen unter Verwendung von Standard-Versionsspezifikationen. Dabei ignorieren sie völlig, wie sich die Runtime-Logik auf einem Enterprise ServerDer zentrale Server in JD Edwards, auf dem die Geschäftslogik und Batch-Prozesse (UBEs) ausgeführt werden. unter gleichzeitiger Multithreading-Ausführung, nicht indizierten Joins auf großen Tabellen wie F0911Die Hauptbuch-Detailtabelle (Account Ledger) in JD Edwards, eine der größten und wichtigsten Tabellen im System. oder F4111 und nicht freigegebenen JDECACHEEine JD Edwards-eigene API zur temporären Speicherung von Daten im Arbeitsspeicher während der Programmausführung.-Speicherbelegungen verhält.
Weitere Beiträge …
Seite 4 von 6